Mettre un texte derrière une image ou une vidéo avec ton IA, sans CapCut
Lecture : 11 min
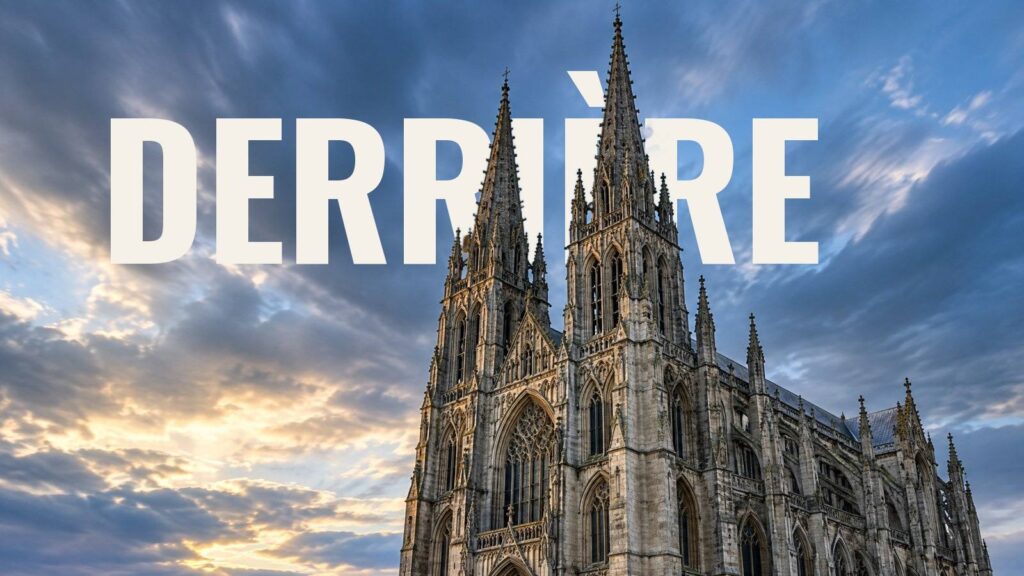
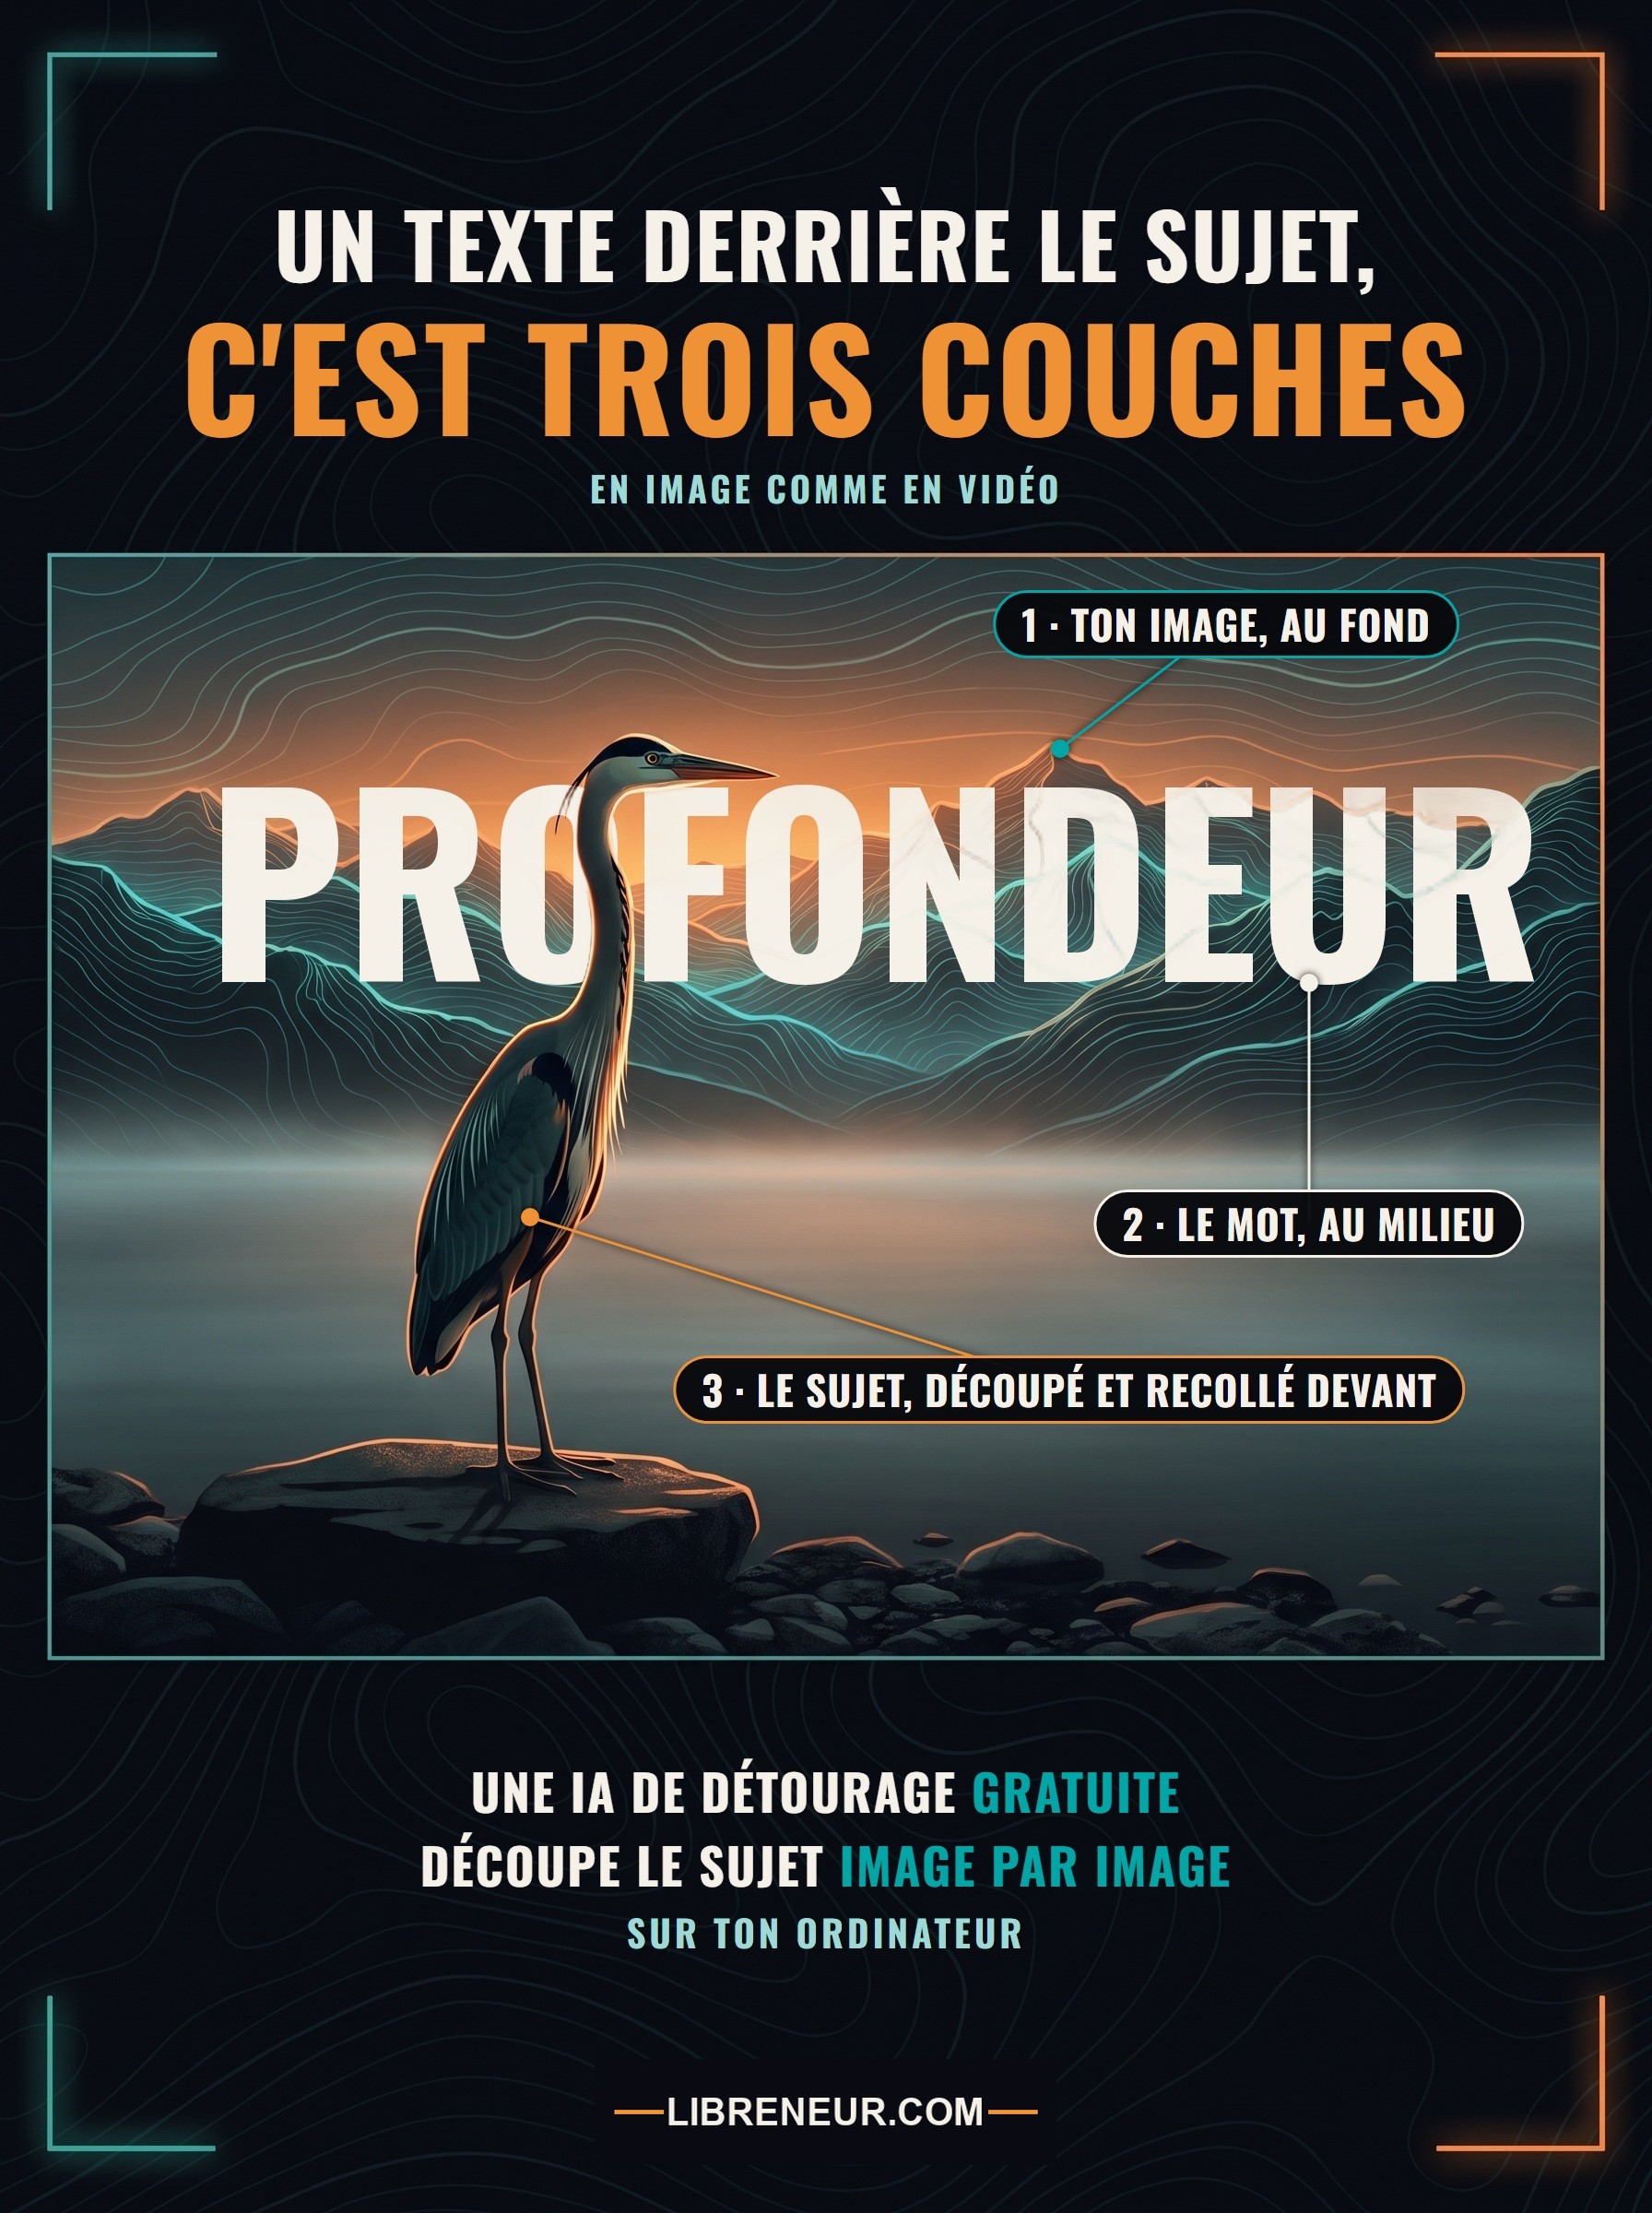
Pour mettre un texte derrière une image, il faut trois couches : ton image au fond, le mot au milieu, et le sujet, découpé puis recollé par-dessus.
Les tutos le font à la main dans CapCut ou DaVinci. Moi, je laisse une IA de détourage gratuite, qui tourne sur mon PC, découper le sujet. Sur une vidéo, elle le fait image par image : le mot reste derrière même quand je bouge la tête.
Et comme mon IA lit la transcription de ma voix, le mot entre pile au moment où je le dis. Je n’ai rien placé moi-même.
Je l’ai poussé partout : vidéo YouTube, Reel, miniature, carrousel, vieux plans filmés au téléphone, images générées. Voilà comment ça marche, là où ça casse, et le kit pour le faire avec ton IA.
Tu préfères regarder plutôt que lire ? Tout est aussi en vidéo :
Pourquoi le texte derrière plutôt que devant
Un texte posé devant l’image, tout le monde en fait. Il flotte par-dessus, et il ressemble à tous les autres.
Le même mot passé derrière le sujet change tout : il donne de la profondeur à l’image, comme s’il faisait partie du décor. L’œil s’arrête dessus.
L’effet n’a rien de nouveau. Sur YouTube, le tuto CapCut le plus vu sur le sujet dépasse 1,6 million de vues, et son équivalent sur DaVinci Resolve en fait presque autant.
Le souci, c’est que tous ces tutos le font à la main : tu dupliques ton plan, tu détoures le sujet, tu glisses le mot entre les deux. Sur une vidéo, ça prend un temps fou.
Résultat, on le voit rarement : dans une intro, sur un moment fort, et c’est à peu près tout. Dommage, parce que c’est justement le genre d’effet qui retient l’attention.
Mettre un texte derrière une image : les trois couches
L’effet repose sur trois couches empilées. Au fond, ton image ou ta vidéo, telle que tu l’as filmée. Au milieu, le mot, posé à plat. Tout devant, le sujet : la personne, l’animal ou l’objet, découpé par une IA et recollé par-dessus.
Le mot se retrouve coincé entre les deux.
Le détourage, fait par une IA gratuite sur ton PC
La couche du dessus est la seule difficile. Il faut découper le sujet au pixel près, ce qu’on appelle le détourage.
Je le confie à rembg, un outil libre de Daniel Gatis qui compte plus de 24 000 étoiles sur GitHub. Son dépôt le présente en une ligne :
« Rembg est un outil qui retire l’arrière-plan des images. »
Daniel Gatis, dépôt GitHub de rembg : « Rembg is a tool to remove image backgrounds. »
Il tourne en local, sur ton ordinateur. Ses modèles se téléchargent une seule fois, un peu moins de 180 Mo chacun, et ensuite aucune image ne part sur Internet.
Sur une vidéo, le découpage est refait à chaque image où le mot est à l’écran. Si je bouge la tête, la silhouette suit, et le mot reste bien calé derrière.
Comment l’IA cale le mot pile quand tu le dis
Tout est calculé en code, et c’est ce qui rend l’IA si précise. Elle ne devine pas le moment : elle le lit dans la transcription de ta voix, où chaque mot a son horodatage.
Dans ma vidéo, « dingue » est prononcé à 29,48 secondes de la prise. Le mot entre à cet instant, pas avant.
Si tu as un fichier de sous-titres, que CapCut, Premiere, DaVinci ou YouTube Studio savent exporter, ton IA y lit l’instant de chaque mot. C’est la même logique que pour mes sous-titres animés. Sinon, tu notes à la main la seconde où tu dis tes mots forts.
Elle cherche aussi où le poser
L’IA ne se contente pas du bon moment. Elle essaie des dizaines de hauteurs pour le mot et garde la meilleure, dans cet ordre :
- aucune lettre cachée à plus de 55 % : au-delà, la lettre disparaît et le mot ne se lit plus ;
- une part cachée stable d’une image à l’autre, pour que le mot ne clignote pas ;
- la hauteur la plus proche de ce que tu lui as demandé.
Et quand aucune place ne marche sur un plan, elle te prévient : le script écrit ILLISIBLE au lieu de te livrer un mot qu’on ne peut pas lire.
Combien de temps ça prend
Sur une image, c’est presque instantané : 6 secondes sur mon PC, pour une photo et un mot.
Sur une vidéo, ce qui coûte, c’est le nombre de mots. Chaque mot oblige l’IA à découper la silhouette sur toutes les images où il passe.
Concrètement, sur un Reel de 84 secondes :
- environ 5 min 23 s pour lire la vidéo, poser les mots et la réécrire, quel que soit le nombre de mots ;
- environ 2 min 9 s de plus par mot, pour le découpage.
Ma machine commence à dater, et chez moi tout tourne sur le processeur : la carte graphique ne sert pas. Sur la tienne, ça ira peut-être plus vite. Dans tous les cas, tu lances, et tu fais autre chose.
Vidéo YouTube, Reel, miniature : le même effet partout
J’ai testé l’effet sur tout ce que j’avais sous la main. D’abord sur ma vidéo YouTube en 16:9, sur un Reel en vertical et sur une miniature.
Sur une miniature, un seul réglage change : cacher moins le mot. Elle s’affiche en tout petit, alors je vise 15 à 25 % du mot caché, contre 30 à 55 % dans une vidéo.
Sur de vieux plans filmés au téléphone
J’ai ressorti d’anciens plans, que je retrouve en les décrivant : un clocher, une rivière, des herbes hautes. Dans les herbes, l’IA a calculé chaque brin pour glisser le mot derrière.
Sur des images et des vidéos générées par IA
J’ai aussi essayé des images générées avec kie (lien affilié, collaboration commerciale avec kie), dans des styles très différents, pour voir si le style posait une limite : pixel art, pâte à modeler, estampe, synthwave, aquarelle. Le style n’en pose pas : ce qui compte, c’est que le sujet se détache.
Et même sur une vidéo générée entièrement par IA, avec Kling : le héron bouge, et PATIENCE reste derrière son cou.
Dans un carrousel, coupé entre deux slides
Ma technique préférée : poser le mot derrière un sujet qui chevauche deux slides. Une image de 2 160 pixels, coupée en deux slides de 1 080. La flèche de la cathédrale tombe sur la couture : GOTHIQUE passe derrière elle d’une slide à l’autre.
Le mot est coupé, donc on se doute qu’il continue, et on a envie d’aller voir la slide d’après. C’est le même principe que l’objet animé qui traverse un carrousel : amener la personne un peu plus loin.
Les limites : là où ça casse
Tout est automatique, donc forcément, il y a des cas où ça ne marche pas. Je les ai gardés, parce que ce sont eux qui te disent comment filmer pour que l’effet tienne.
Un objet devant toi : il faut une deuxième IA
Le premier modèle que j’ai téléchargé ne découpe que les personnes. Le dépôt de rembg le décrit comme « un modèle pré-entraîné pour la segmentation des humains ».
Mon micro, il ne le voyait pas : le mot passait devant le micro, alors que le micro est devant moi. J’ai ajouté un second modèle, qui sait découper les objets, et j’ai combiné les deux. Le micro est revenu devant le mot.
Pas de sujet qui se détache, pas d’effet
Sur un paysage, il n’y a rien à découper : le mot reste devant, 0 % caché. En sous-bois, le second modèle ne trouve que 2 % de l’image, quelques troncs au loin, et pas celui du premier plan.
C’est l’IA qui choisit le sujet
Ces modèles ne sont pas entraînés sur un objet en particulier. Ils cherchent ce qui ressort de l’image. Le premier vient de U²-Net, un réseau que ses auteurs présentent ainsi :
« Nous concevons une architecture de réseau profond simple, mais puissante, U²-Net, pour la détection d’objets saillants. »
Xuebin Qin et ses coauteurs, « U²-Net: Going Deeper with Nested U-Structure for Salient Object Detection », 2020 : « we design a simple yet powerful deep network architecture, U²-Net, for salient object detection (SOD). »
Saillant, c’est ce qui se détache du reste. Donc si deux choses se détachent ensemble, l’IA peut les prendre ensemble. Sur une image de bivouac, un modèle a pris la lanterne seule, l’autre la lanterne, la branche et la tente. Sur un palmier synthwave, le soleil a été découpé avec le palmier : NOSTALGIE passe derrière le soleil.
Un sujet trop large avale les lettres
Si le sujet prend trop de place, il cache trop de lettres. Sur ce buste, ÉTERNEL perd son E, son R et son N, cachés à plus de 55 % : le mot ne se lit plus.
Pas assez de place au-dessus de la tête
Il faut penser tes plans. Moi, en tournage, je regarde mon retour vidéo, et je laisse très peu d’espace au-dessus de ma tête. Sur ce cadrage, le G de DINGUE est caché à 96 %.
Si tu filmes pour cet effet, recule et laisse au moins un quart de la hauteur vide au-dessus de ta tête.
Trop de mouvement, ça scintille
L’IA suit bien un sujet qui bouge. Mais s’il y a trop de mouvements, trop rapides, la découpe change d’une image à l’autre et le bord du mot scintille. Là, ce n’est plus utilisable.
Deux tests en direct : une tasse et un selfie
Au tournage, j’ai lancé deux essais pour voir ce que ça donnait en direct. Avec une grosse tasse à la main, les deux modèles font bien la différence : le mot se cale derrière la tasse.
Par contre, ça scintille à cause de mon siège. Son dossier est une sorte de grillage transparent, et l’IA ne sait pas trancher. Il me faudrait une autre chaise.
Le deuxième, en selfie au téléphone devant un fond uni : aucun problème, ça marche parfaitement.
Où utiliser l’effet, avec parcimonie
Tu peux t’en servir dans beaucoup de situations. Mon conseil : garde-le pour les moments forts, là où tu dois capter l’attention. Trop d’effets tuent l’effet, et chaque mot coûte du temps de calcul.
Là où il marche le mieux :
- une miniature ou une couverture de carrousel : une image, quelques secondes de calcul ;
- une vidéo YouTube : sur les mots où tu veux vraiment appuyer, ou sur tes titres de chapitre ;
- une vidéo faceless : au moment où il faut relancer l’attention.
Et comme tout est en code, il n’y a rien à générer ni à payer. Tu le lances pendant ton montage, et il se glisse dans ta façon de créer, avec des IA qui tournent chez toi.
Le faire avec ton IA : le kit
J’ai tout rassemblé dans un kit que tu donnes à ton IA, Claude, ChatGPT ou celle que tu utilises déjà. Il y a quatre pièces :
- le mode d’emploi à coller dans ton IA : les réglages, comment choisir les mots, lire le résultat, et tout ce qui casse ;
- deux exemples prêts à relancer : PATIENCE derrière un héron, HÉRITAGE et SILENCE derrière un clocher ;
- le script qui fait le travail, pour une image comme pour une vidéo ;
- les outils gratuits à installer, et comment les installer.
Ensuite, tu lui demandes en français ce que tu veux, comme « fais passer LIBERTÉ derrière moi dans cette vidéo, entre 3 et 5 secondes », ou « une miniature avec DINGUE derrière ma tête ». Elle écrit les réglages et te donne la commande à lancer.
Côté outils, il te faut Python, rembg et ffmpeg, trois outils gratuits. Le script vérifie au démarrage ce qui manque et te le dit. Et si un résultat te surprend, demande à ton IA de relancer avec la teinte : elle colore en teal ce qui a été découpé, et tu vois tout de suite ce que l’IA a pris pour le sujet.
Dans la Tribu des Libreneurs, ma communauté gratuite : le mode d’emploi à coller dans ton IA, les deux exemples, le script et les outils gratuits.
Questions fréquentes
Comment mettre un texte derrière une personne dans une vidéo ?
Il faut découper la personne sur chaque image de la vidéo, poser le mot sur l’image d’origine, puis recoller la personne par-dessus. Une IA de détourage comme rembg le fait automatiquement et gratuitement, sur ton ordinateur.
Pourquoi le mot passe devant le sujet au lieu de derrière ?
Parce que l’IA n’a pas reconnu ce sujet. Un modèle entraîné sur les personnes ignore un micro ou une tasse : prends un modèle qui découpe aussi les objets, ou combine les deux.
Faut-il savoir coder ?
Non. Tu colles le mode d’emploi du kit dans ton IA et tu lui décris ce que tu veux en français. Elle écrit les réglages et te donne la commande à lancer.
Mes images partent-elles sur Internet ?
Non. Le découpage tourne sur ton ordinateur. Seuls les modèles se téléchargent, une fois, au premier lancement.
Combien de temps faut-il ?
Quelques secondes pour une image. Pour une vidéo, compte environ 5 minutes pour un Reel d’une minute et demie, plus 2 minutes par mot, sur mon PC.
Ce qu’il faut retenir
- Le texte derrière, ce sont trois couches : ton image, le mot, et le sujet découpé par-dessus.
- Une IA de détourage gratuite et locale découpe le sujet image par image, et la transcription cale le mot sur ta voix.
- Ça casse quand le sujet ne se détache pas, prend trop de place ou bouge trop vite.
- Garde-le pour les moments forts : une miniature, une couverture de carrousel, les mots clés d’une vidéo.
Le kit t’attend dans la Tribu. Montre-moi le premier mot que tu fais passer derrière toi !

Un autre article pourrait t'intéresser